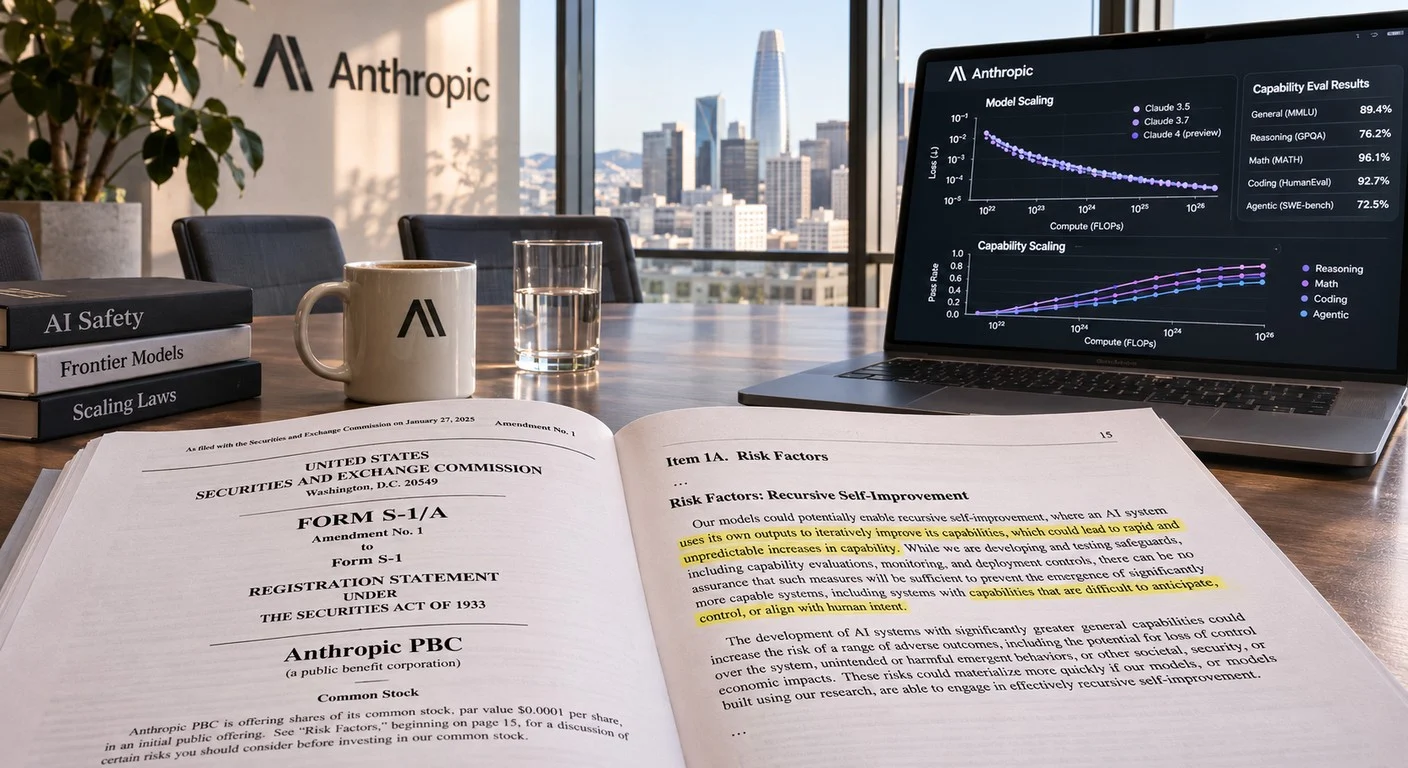
Trong bản cáo bạch sửa đổi S-1/A vừa đệ trình lên Ủy ban Chứng khoán và Giao dịch Mỹ (SEC), bên cạnh các số liệu tài chính phản ánh doanh thu tăng vọt cùng chi phí leo thang, Anthropic đã bổ sung một chi tiết đáng chú ý vào phần đánh giá rủi ro: khả năng doanh nghiệp này đang tiến rất gần đến ngưỡng phát triển mô hình có thể tự cải tiến đệ quy (Recursive Self-Improvement – RSI).
Định nghĩa và hiểm họa từ khả năng tự cải tiến đệ quy (RSI)
Khái niệm tự cải tiến đệ quy (Recursive Self-Improvement – RSI) mô tả thời điểm một hệ thống trí tuệ nhân tạo đạt trình độ tự huấn luyện và tối ưu hóa chính nó hiệu quả đến mức tạo ra sự tăng tốc đột biến về năng lực điện toán và nhận thức. Hiện tượng này thường được ví như bước ngoặt kích hoạt một vòng lặp tự nâng cấp liên tục.
Đối với nhóm các nhà nghiên cứu lo ngại về an toàn AI (AI doomers), RSI là lằn ranh đỏ không thể quay đầu. Khi AI có khả năng tự tái thiết kế ở cấp độ vượt xa tầm kiểm soát của con người, hệ thống có thể gây ra những tổn hại khôn lường trong quá trình thực hiện mục tiêu được giao. Ngược lại, nhóm ủng hộ công nghệ lại xem RSI là chìa khóa mở ra tiềm năng năng suất vô hạn, thúc đẩy các phát kiến khoa học và kỹ thuật với tốc độ chưa từng có tiền lệ.
Cảnh báo chưa từng có trong hồ sơ rủi ro của Anthropic
Trong hồ sơ mới cập nhật, Anthropic xác nhận họ đang chủ động ứng dụng chính các mô hình AI vào quy trình nghiên cứu và phát triển (R&D). Tuy nhiên, phòng thí nghiệm này cũng thẳng thắn thừa nhận nguy cơ đi kèm:
“Việc sử dụng AI để hỗ trợ xây dựng các hệ thống AI có năng lực cao hơn có thể mang lại rủi ro an toàn nghiêm trọng, đặc biệt nếu quá trình này đẩy nhanh tốc độ tiến bộ một cách đột ngột. Đây là một trong những phạm vi được điều chỉnh bởi Chính sách nhân rộng có trách nhiệm (Responsible Scaling Policy – RSP) của chúng tôi, nhằm giám sát và giảm thiểu rủi ro khi tiến gần tới ngưỡng tự cải tiến đệ quy.”
Đáng chú ý, Anthropic đã bổ sung hai luận điểm then chốt trong mục yếu tố rủi ro. Thứ nhất, công ty từng sử dụng AI để phát triển các mô hình mới mà bước nhảy vọt về năng lực của chúng không được nhận diện kịp thời ngay tại thời điểm diễn ra. Thứ hai, các thế hệ mô hình tương lai có thể sớm thỏa mãn định nghĩa nội bộ về RSI:
“Các ước tính nội bộ và kỳ vọng đối với các mô hình tương lai chỉ ra rằng chúng tôi có thể sắp đạt đến định nghĩa của Chính sách nhân rộng có trách nhiệm về ‘sự tiến bộ tăng tốc đột biến bắt nguồn từ AI’. Hiện tại, chúng tôi chưa chỉ định bất kỳ mô hình hiện hành nào vượt qua ngưỡng này và vẫn đang tiếp tục đánh giá dữ liệu nền tảng.”
Cam kết duy trì kiểm soát của con người trong nghiên cứu
Mặc dù thừa nhận nguy cơ RSI đang đến gần, Anthropic khẳng định chưa có mô hình thương mại nào hiện nay – bao gồm cả dòng mô hình Claude – vượt qua lằn ranh tự phát triển độc lập hoàn toàn. Doanh nghiệp cam kết sẽ luôn duy trì sự hiện diện của con người trong chu trình nghiên cứu (human-in-the-loop).
Theo tuyên bố trong hồ sơ, Anthropic không có kế hoạch để Claude tự động thiết kế và tạo ra các thế hệ mô hình tiên phong (frontier models) kế tiếp mà thiếu đi sự giám sát hoặc hiểu biết thấu đáo từ các chuyên gia con người. Công ty đang cân nhắc cập nhật thêm các tiêu chuẩn trong chính sách RSP để bảo đảm quyền kiểm soát tuyệt đối trước khi công nghệ này đạt tới độ chín muồi về mặt kỹ thuật.
Dù hồ sơ S-1 vừa đóng vai trò minh bạch rủi ro pháp lý vừa là công cụ thu hút sự chú ý của giới đầu tư trước thềm phát hành cổ phiếu, những bước tiến thần tốc của Claude trong các mảng lập trình, toán học và an ninh mạng thời gian qua là minh chứng cho thấy tốc độ phát triển của AI đang diễn ra nhanh hơn dự tính.
Nguồn: TechCrunch